你有没有碰到过, 程序突然间奔溃掉, core dump 文件都一堆, 然而却搞不清楚从哪里着手去查? 又或者服务器之中, CPU飙升到300%, 可是用top查看一番, 全都是些陌生的函数? 别慌张, 这并非是因为你能力不足, 而是因为没有把工具运用好。
钻研Linux的研发工作, 最为惧怕的情形就是, 当出现问题之际, 手头仅仅仅只有一把锤子而已。实际上, 调试方面、监控方面、性能分析方面、空间管理方面, 每一个环节都存在着与之相对应的得力工具。就在现今这天, 咱们先来聊一聊这套具备实战性质的工具链, 从GDB一直聊到perf, 再从free聊到iostat, 以此助力你构建起“观察→诊断→优化”这样一种闭环思维。
先来讲调试, GDB属于基本功, 编译之时加个`-g`, 设置断点、进行单步操作, 同时打印变量, 上述种种之事皆并非难事。 不过, 真正令人恼火的是那些偶尔出现的崩溃情况, 例如SIGSEGV(段错误)。 不要仅仅去查看最后一行, 尝试运用`frame`切换至不同的栈帧, 瞧瞧局部变量, 往往就能发现数组越界或者存在野指针的问题。
ASan(AddressSanitizer)更为狠厉, 编译之时添加`-fsanitize=address`, 运行之后会自动对堆内存越界、使用已释放内存以及double free这些情况予以检测, 它较GDB更为敏锐, 能够直接将错误类型以及调用栈调用栈调用告知你, 先借ASan进行定位, 再借GDB加以复现验证, 二者相互配合, 内存泄漏便无处遁形。
万一core dump里面仅仅存在一个十六进制的地址, 先别慌张, 运用`addr2line -e program address`将其转化为源代码行号, 就算符号表已经丢失了, 同样能够起到救急的作用。
说性能监控这方面,好多人仅仅会去看top的CPU使用率, 然而实际上存在一个隐藏着的陷阱, 那就是`wa`(等待I/O)要是超过了30%, 这表明磁盘或者网络才是造成瓶颈的关键所在, 可别傻乎乎地去对CPU进行优化操作。按照`P`能够按CPU进行排序, 按照`M`能够按内存进行排序, 按照`1`能够查看每个核, 这些都属于基本的操作行为。
htop的直观性更强, 彩色进度条能够让人一眼就看出CPU、内存以及swap的使用状况。负载值和CPU核数存在联系: 当负载低于0.7倍核数时属于正常情况, 要是超过1倍那便需要警惕起来, 倘若超过5倍则表明系统基本上已经濒临崩溃。
如果想到达函数级别深入的程度, 那就需要使用perf。利用`perf top`能够实时去查看CPU占用率最高的函数, 借助`perf record -ag -- sleep 15`进行采样从而收集调用栈, 之后通过`perf report`来查看热点函数所占的比例。要是发现有某一个函数占据了60%的CPU, 那么就要针对这个函数去进行算法优化或者内联。和gprof相比较而言, perf采样所产生的开销比较低, 比较适合生产环境。
将系统级问题通过vmstat以及iostat来查看表现, `vmstat 1`用于对进程、内存、swap、I/O以及上下文切换进行监控, `iostat -x 1`用以查看磁盘的读写速率、平均等待时间也就是await以及利用率即%util等情况。需要特别留意的是, %util达到100%并不必然意味着磁盘处于满负荷运转状态, 还需进一步查看await的情况。假如await数值很大才存在问题, 而%util虽高但await数值较小, 那么有可能表明是多队列并发处于正常范畴。
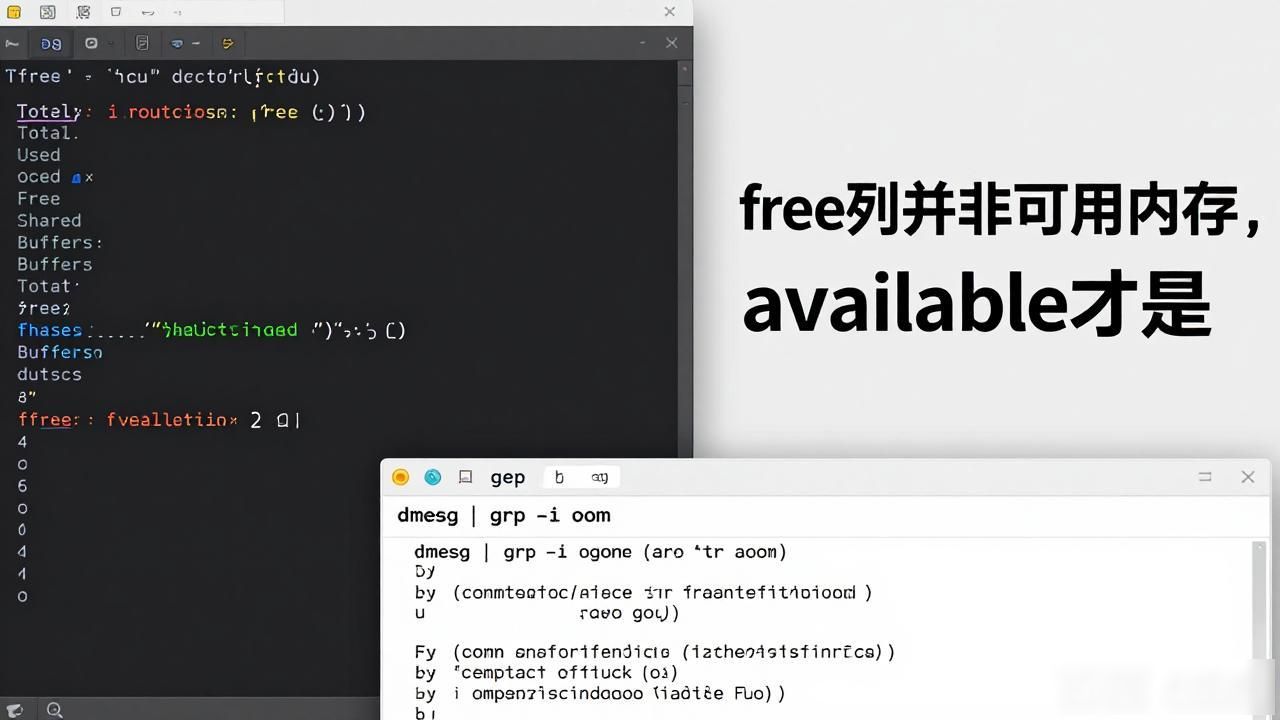
关于内存以及磁盘空间的排查, free命令存在一个常见的误区, 不少人觉得free列便是可用内存, 然而实际上available才是。buff/cache能够被系统回收, 所以当available快要接近0的时候, 系统有可能引发OOM Killer, 通过使用`dmesg | grep -i oom`来查看被杀掉的进程。
当出现OOM的时候, 首先执行`free -h`, 接着执行`top`并按照内存进行排序, 进而寻找到高占用进程, 以此判断是否发生泄漏。临时的方案能够配置swap, 然而这会造成性能下降;长期的方案还是需要修复代码或者使用cgroup来限制内存。
对于磁盘空间管理, 借助`df -h`查看挂载点, 运用`du -sh *`排查目录大小。要是删除了文件然而`df`呈现空间未释放, 解释为进程仍存持有文件描述符, 通过`lsof | grep deleted`寻觅到它, 进行重启又或者将其kill掉。
直至最终, 针对iostat展开深度剖析探究, 其核心要点就在于await和svctm二者之间的比值情况。倘若await远远大于svctm, 这便意味着存在着I/O排队现象。数据库所处于应用的情境之际, 通常会面对随机式读与写的状况, 在此种情形下, 降低await相较于提升带宽而言, 显得更为关键重要。
最能说明问题的是实战案例, 比如说程序出现偶发崩溃, coredump显示SIGSEGV, 然后用GDB定位到`strcpy`, 接着再用ASan进行重新编译, 结果报错堆缓冲区溢出, 在修复的时候把固定长度数组改为动态分配或者`strncpy`。
再比如说, Java服务出现CPU飙升的情况, 通过`top`发现Java进程占据了300%, 由`perf top`显示热点处于G1YoungGen垃圾回收函数那里, 再配合`jstat`发现存在频繁Full GC现象, 接着调整堆内存参数或者对堆转储展开分析来解决。
有磁盘空间方面的告警出现, 通过`df -h`查看发现根目录处于已满的状态了, 利用`du -sh /*`探寻得知`/var/log`所占空间极大地, 接着运用`lsof +L1`寻找到虽然已经被删除可仍然被进程所占有的日志文件, 随后进行重启服务的操作, 之后再对logrotate进行定时轮转的配置。
要记好, 工具并非是目的所在, 而理解系统原理才是最为关键的根本之处。内存管理、I/O调度以及进程调度, 这些属于底层的知识内容才是起到关键作用的钥匙。遇到了问题的时候, 首先得查看整体方面(比如top/free/df)的情况, 随后进行局部定位(像是perf/iostat), 最终深入到细节层面(例如GDB/ASan)。每一个工具都算是一把钥匙, 然而只有当你弄清楚了门的具体结构之后, 才能够正确地运用钥匙去打开那扇正确的门。
你平常碰到最为麻烦难搞的Linux方面的问题是啥, 借助了哪一个工具将其解决的, 在评论区域交流讨论一番, 大伙共同迈进向前发展进步。