近日, 360 AI安全研究院推出了《AI安全系列报告: 智能体安全新范式——当AI有了“手和脚”, 企业安全边界必须重建》, 简称《报告》。这份《报告》表明, 由于智能体加快进入企业办公、研发、运维、客服等核心业务场景, AI安全的核心问题正从“生成风险”转变为“执行风险”。
以往, 大模型安全着重关注的是AI会不会出现“说错话”这种情况, 像是存在幻觉、发生越狱、出现违规输出以及导致敏感信息泄露等。然而, 当智能体开始去调用工具、开始访问数据并且开始执行真实任务的时候, 它所带来的最大风险正转变成为“做错事”了。
《报告》提出了“合法动作的非法后果”这一概念, 该概念被用于描述一种风险形态, 这种风险形态是指智能体在具备正常身份, 使用正常工具, 遵循正常流程的情况下, 由于恶意诱导, 或者逻辑误判, 又或者上下文污染, 最终执行出违背业务意图, 或者超出安全边界结果的情况。
智能体安全六层攻击面模型
该《报告》提出智能体安全六层攻击面模型, 借助此模型能有助于企业从身份、工具、数据、记忆、行为以及运行环境等多个维度去重建安全边界, 其可将企业级智能体攻击面分解为人机交互层、通信调用层、组件间层、智能体之间这一层、工具调用层以及基础运行环境层, 目的在于能识别智能体风险究竟是从哪里进入的, 同时明确企业安全边界到底应该建在何处。面对这样的变化, 360围绕智能体安全提出了“意图检测、环境隔离、逻辑纠偏”这三大发力点, 并且形成了“端+云+管理平台”的能力闭环。
当中, 端侧着重去解决一些问题, 像智能体运行环境能够被控制, 高风险动作可以被阻断, 以及敏感数据能够得到保护等;云端侧重于持续进行Skill检测, 开展漏洞运营, 沉淀风险特征并更新安全策略;管理平台侧重于智能体资产的发现, 实现风险可视化, 进行行为审计以及策略编排,以此来助力企业从单点防护朝着体系化治理迈进。
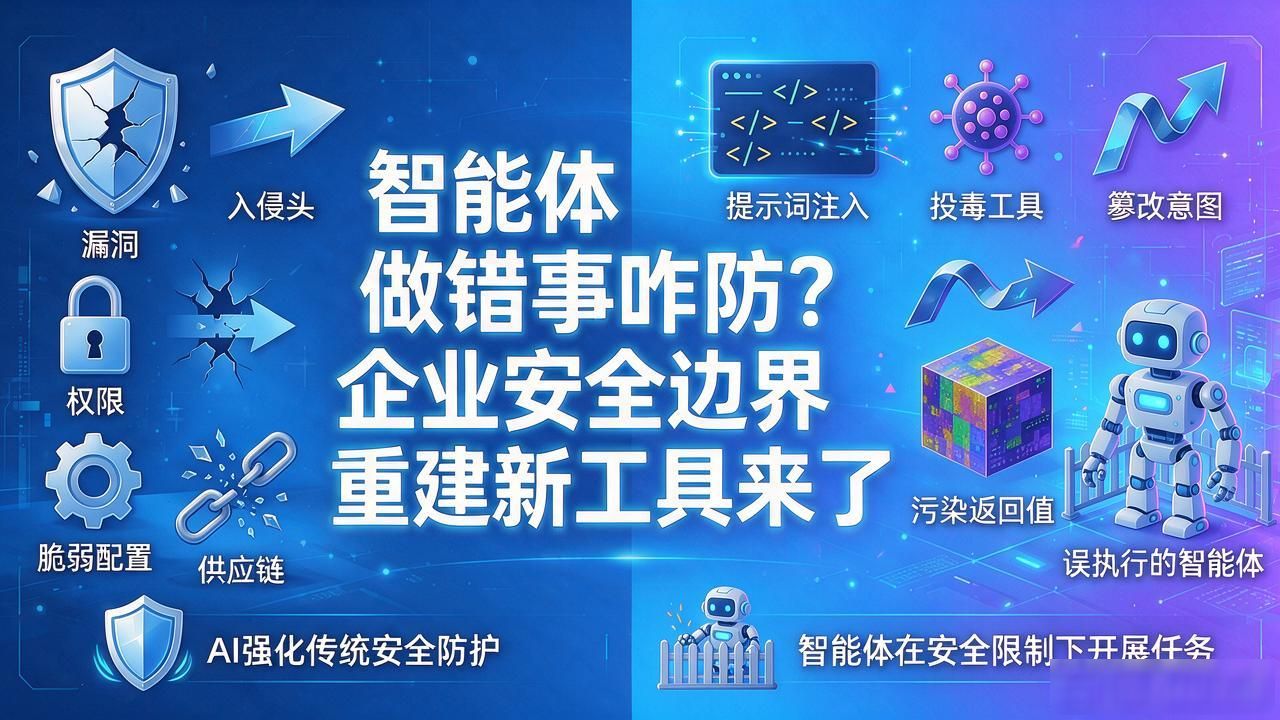
《报告》持有这样的观点, AI安全它是同时涵盖着两类问题的, 一类问题是属于“确定性计算”当中那传统的安全问题, 就好比漏洞、入侵、权限控制、配置脆弱以及供应链风险这些;另一类问题则是由“不确定性计算”所带来的新的安全问题, 像提示词注入、工具投毒、意图篡改、返回值污染以及智能体误执行这些。对于这两类问题, 360给出了两条解决途径: 其一, 借助AI强化传统安全防护, 提升漏洞发觉、入侵判断、样本剖析及响应处理的效能;其二, 使不确定性任务在安全限制下开展, 使得智能体能够做事, 然而不可超越界限。
《报告》另外指明, Skill现今正演变成智能体生态里颇为关键的风险进入之口。Skill身为智能体用以调用外部工具、去连接业务系统的关键部件, 本来已然变成了智能体能力链条的其中一部分。一旦Skill有安全方面存在的问题, 风险可不止局限于单个插件层面, 甚至还能够进一步对企业账号体系、数据资产、业务系统以及合规管理造成影响句号。
近期备受人们关注的龙虾(OpenClaw), 它是目前正处于迅猛快速发展阶段的典型智能体生态形态之一范畴之内展现而言的那个形态。在OpenClaw以及与之类属同等关联情况的智能体生态体系环境当中, Skill此项事物实则为智能体能力得以实现向外扩展延伸的极为重要关键的承载依托之物。智能体能不能够去执行诸如邮件发送、数据查询、文件处理、业务流转这类任务, 通常情况下往往是取决于它自身所能够实行调用的Skill这个因素条件决定的此等情况。所以, OpenClaw类型范畴的平台安全存在的相关系列问题, 不仅仅只是局限于智能体本体安全方面所涉及存在的问题, 而且还涵盖至Skill准入、权限边界、运行过程审计以及工具调用治理这些更多方面所关联涵盖的问题。
十大高风险Skill类型
360沙箱云 - SKILLS分析平台, 其针对Skill安全, 面向AI Agent Skill生态, 能提供安全检测, 还具备云鉴定能力, 支持多种提交方式, 涵盖Skill文件压缩包、Skill详情页、下载地址, 检测流程包含多个环节, 有静态分析、AI意图识别、动态沙箱和持续运营等, 能帮助不同主体, 即开发者、企业安全团队、智能体使用者, 在Skill上线前就识别潜在风险。
首先, 360 AI安全研究院持有这样一种观点, 其认为, 对于智能体安全而言, 关键之处并非在于让智能体少去做事情, 而是在于要让智能体于可信边界范围之内去从事正确的事。其次, 它还指出, 没有边界的那种自治状态, 其实质是风险;而具备边界的自治, 才能够称得上是生产力。最后, 随着智能体加快迈入企业工作流这一进程, “先安全、后自治”正逐步成为企业在部署智能体时必须要回答的前置问题。